 中文
深入了解 Googlebot:揭开抓取、获取和我们处理的字节数之谜
星期二,31 月 2026 日
如果你收听了 Search Off the Record 播客第 105 期, 可能听过我们深入探讨一个与我们息息相关 (也与我们的服务器息息相关)的主题:Googlebot 的内部工作原理。
长期以来,“Googlebot”这个名字让人联想到一个不知疲倦、系统地阅读互联网的机器人。但实际情况要复杂一些,也有趣得多。今天,我们想揭开抓取基础设施的面纱,特别聚焦于那个让我们自己也颇为头疼的问题:字节大小限制。
首先,Googlebot 并不是一个单一程序
我们先来澄清一个历史遗留的误称。在 2000 年代初期,Google 只有一个产品,所以我们只有一个爬虫。“Googlebot”这个名字就此沿用下来。但如今,Googlebot 只是一个类似于集中式抓取平台的用户。
当你在服务器日志中看到 Googlebot 时,你看到的其实是 Google 搜索。数十个其他客户端——Google Shopping、AdSense 等——也会使用不同的爬虫名称,通过同一套底层基础设施发送抓取请求。较大型客户端的相关信息记录在 Google Crawler infrastructure 网站上。
2MB 限制:你的字节会发生什么?
这部分容易让人有些困惑。抓取基础设施的每个客户端都需要为抓取设置一些参数。这些参数包括用户代理字符串、它们将在 robots.txt 中查找的用户代理标记,以及从单个 URL 获取的字节数。
Googlebot 目前对任意单个 URL 最多获取 2MB(PDF 除外)。这意味着它只会抓取资源的前 2MB,其中包括 HTTP 标头。对于 PDF 文件,限制为 64MB。
图片和视频爬虫通常有一系列不同的阈值,具体取决于它们所服务的产品。例如,获取网站图标的限制可能很低,而图片搜索则不然。
对于未指定限制的其他爬虫,无论内容类型如何,默认限制均为 15MB。
这对服务器通过网络发送的字节意味着什么?
- 部分获取: 如果 HTML 文件大于 2MB, Googlebot 不会拒绝该网页,而是在达到 2MB 的上限时立即停止获取。请注意,此限制包含 HTTP 请求标头。
- 处理截断内容: 下载的这部分内容(前 2MB 字节)会被传递给我们的索引系统和 Web Rendering Service (WRS),并被当作完整文件处理。
- 未获取的字节:任何存在于之后该 2MB 阈值之外的字节都会被完全忽略。它们不会被获取、不会被渲染,也不会被编入索引。
- 加载资源: HTML 中引用的每项资源(媒体、字体及少数特殊文件除外)都会由 WRS 像处理父级 HTML 一样通过 Googlebot 获取。每项资源都有各自独立的 URL 字节计数器,不计入父页面的大小。
对于绝大多数网站而言,2MB 的 HTML 载荷已经非常庞大,你永远不会触及这一限制。不过,如果页面包含臃肿的内联 base64 图片、大块内联 CSS/JavaScript,或者开头就有数 MB 的菜单内容,就可能不小心把实际文本内容或关键结构化数据推到 2MB 限制之后。如果这些关键字节没有被获取,在 Googlebot 看来,它们就根本不存在。
渲染这些字节
爬虫成功获取字节(不超过限制)后,就会将处理工作交给 WRS。WRS 会处理 JavaScript,并像现代浏览器一样执行客户端代码,以理解网页最终的视觉和文本状态。渲染过程会加载并执行 JavaScript 和 CSS 文件,并处理 XHR 请求,以便更好地理解网页的文本内容和结构(它不会请求图片或视频)。对于每项请求的资源,2MB 限制同样适用。
不过请记住,WRS 只能执行爬虫实际获取到的代码。此外, WRS 以无状态方式运行 ——每次请求之间都会清除本地存储和会话数据。这可能会对我们的系统如何解读动态、依赖 JavaScript 的元素产生特定影响。
字节处理最佳实践
为确保 Googlebot 能够高效获取并理解你的内容,请牢记以下字节层面的最佳实践:
- 精简 HTML: 将较大的 CSS 和 JavaScript 移至 外部文件。虽然初始 HTML 文档的上限为 2MB,但外部 脚本和样式表会单独获取(并受各自限制约束)。
-
顺序很重要: 将最关键的元素——
例如 meta 标签、
<title>元素、<link>元素、规范链接以及必要的结构化 数据——放在 HTML 文档靠前的位置。这样可以降低它们落在截断位置之后的可能性。 - 监控服务器日志: 密切关注服务器 响应时间。如果服务器难以发送字节,我们的爬虫会自动放慢抓取速度,以免基础设施过载,这会导致抓取频率下降。
请注意,此限制并非一成不变,随着网络发展和 HTML 页面体积增大,限制可能会随时间变化。(也可能变小。希望会变小。)
抓取并非魔法,而是经过高度协调、规模化进行的字节交换。了解我们的中央获取基础设施如何检索并限制这些字节,你就能确保网站最重要的内容始终能被纳入其中。
祝你优化顺利!
想了解更多幕后详情?请在 YouTube 上收听 Search Off the Record 播客第 105 期,或在你常用的播客平台收听!
发布者: Gary。
来源:原网站 · 阅读原文
相关学习内容
用于优化 Google 搜索生成式 AI 的新资源
15 月 2026 日,星期五 随着人们越来越倾向于使用生成式 AI 体验,并以新的方式查找信息,我们发布了一份新资源,帮助网站所有者、SEO 专业人士……
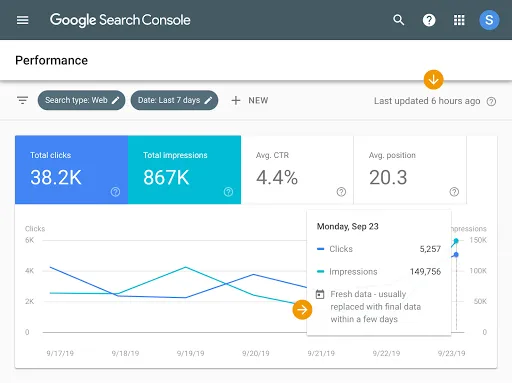
网站“搜索效果”报告中的数据更新更及时
星期一,九月 23,2019 我们分析了用户反馈,今天想宣布这份报告的一项新改进,此改进源于用户提出的第 #1 项功能需求——数据更新更加及时……
借助全新的 AI 配置简化 Search Console 分析
星期四,十二月 4 日,2025 年 Search Console 效果报告是分析自然搜索流量的强大工具,但找到所需的确切数据可能比你希望的耗时更长,……